Les prix de l'IA grand public et professionnelle s'effondrent en juillet 2026 : Claude Opus 5, GPT-5.6 Luna et Gemini 3.6 Flash ont tous réduit leur coût en l'espace de dix jours. Si vous hésitez encore à automatiser certaines tâches répétitives, la conjoncture vient de basculer en votre faveur.
L'essentiel
- Les prix des modèles d'IA majeurs (Claude Opus 5, GPT-5.6 Luna, Gemini 3.6 Flash) ont baissé en juillet 2026, avec une réduction spectaculaire de 80 % pour Luna et des gains de capacité pour Opus 5 sans augmentation tarifaire.
- La pression concurrentielle des modèles chinois comme DeepSeek V4 Pro, qui capturent 46 % de l'usage de tokens en entreprise, explique cette guerre tarifaire entre les géants américains de l'IA.
- Pour les applications web boostées à l'IA en production, ces baisses de prix permettent de monter en gamme vers des modèles plus puissants (Claude Opus 5) sans réviser le budget global, améliorant ainsi la qualité des outputs.
- L'automatisation devient rentable sur de nouvelles catégories de tâches : celles répétitives à fort volume et faible enjeu unitaire (tri d'emails, support niveau 1, extraction de données) bénéficient directement de ces tarifs réduits.
- Le coût réel d'un projet IA dépend moins du prix au token affiché que de l'architecture complète (contexte fourni, nombre d'allers-retours, intégration métier), ce qui rend la flexibilité du modèle plus importante que son tarif brut.
Pourquoi OpenAI a-t-il réduit GPT-5.6 Luna de 80 % seulement trois semaines après son lancement ?
OpenAI a agressivement réduit les tarifs pour répondre à une clientèle sensible aux coûts et contrer la concurrence chinoise. Les modèles chinois avaient capturé 46 % de l'usage de tokens en entreprise selon une enquête CNBC, forçant OpenAI à sous-coter DeepSeek pour rester compétitif.
Est-ce que la baisse de prix de Claude Opus 5 est réelle ou juste une augmentation de capacité sans baisse de tarif ?
La baisse est relative : le tarif reste identique à Opus 4.8 (5 dollars en entrée, 25 dollars en sortie), mais la capacité délivrée augmente significativement puisque Opus 5 s'approche de Claude Fable 5. À budget constant, vous obtenez donc davantage pour le même coût.
Quels types de tâches dois-je automatiser en priorité avec ces nouveaux tarifs ?
Privilégiez les tâches répétitives à fort volume et faible enjeu unitaire : tri d'emails, support niveau 1, fiches produits, extraction de données de factures. Gardez l'humain sur les décisions qui engagent vraiment, comme le recrutement ou la gestion de litiges clients.
Si le prix au token baisse, ma facture d'API va-t-elle nécessairement baisser aussi ?
Pas nécessairement. Le coût réel dépend de l'architecture globale : longueur du contexte injecté, nombre d'allers-retours entre le modèle et votre système, qualité de vos données, et surtout la couche d'intégration (70 % du coût réel selon l'auteur). Deux équipes utilisant le même modèle au même tarif peuvent avoir des factures très différentes.
Envoyez cet article à votre assistant IA préféré : il vous le résumera en quelques secondes.
Sommaire8 sections
Trois annonces en dix jours : ce qui s'est passé concrètement
Un token, c'est à peu près les trois quarts d'un mot. C'est l'unité de facturation de tous les modèles de langage (LLM), de ChatGPT à Claude. Comprendre le prix au million de tokens, c'est comprendre la facture réelle d'une automatisation à volume. Voici les faits datés.
Gemini 3.6 Flash (21 juillet) : Google a sorti Gemini 3.6 Flash le 21 juillet 2026, à 1,50 dollar le million de tokens en entrée et 7,50 dollars en sortie, plus rapide et moins cher que Gemini 3.5 Flash. La double économie est là : le modèle produit environ 17 % de tokens de sortie en moins pour la même tâche, raisonne en moins d'étapes et génère moins d'appels d'outils sur les workflows multi-étapes. Vous payez donc un tarif inférieur sur un volume de tokens réduit.
Claude Opus 5 (24 juillet) : Anthropic a lancé Claude Opus 5 le 24 juillet 2026, décrit comme un modèle qui approche l'intelligence de pointe de Claude Fable 5 pour moitié moins cher. Le tarif API est identique à celui d'Opus 4.8, soit 5 dollars le million de tokens en entrée et 25 dollars en sortie. C'est la capacité qui monte, pas le tarif qui descend. Quiconque était sur Opus 4.8 obtient un bond de capacité sans débourser un dollar de plus, en changeant simplement l'identifiant du modèle.
GPT-5.6 Luna (30 juillet) : c'est le mouvement le plus spectaculaire. Le 30 juillet 2026, OpenAI a réduit le coût de GPT-5.6 Luna de 80 %. Le prix de Luna, le modèle le plus rapide et le moins cher de la gamme GPT-5.6, est passé de 1 dollar à 0,20 dollar par million de tokens en entrée, et de 6 à 1,20 dollar en sortie. Cette décision agressive est intervenue trois semaines seulement après le lancement de la famille GPT-5.6 le 9 juillet 2026.
Pourquoi cette guerre des prix ? La pression chinoise explique tout
On ne baisse pas de 80 % le prix d'un modèle lancé trois semaines plus tôt par générosité. OpenAI est sous pression pour répondre à une clientèle plus sensible aux coûts et contrer la concurrence des startups chinoises et d'autres géants technologiques.
Les chiffres sont éloquents. Une enquête de CNBC publiée le 7 juillet 2026 a révélé que les modèles chinois ont capturé 46 % de l'usage de tokens en entreprise sur OpenRouter, dépassant parfois les modèles d'origine américaine. DeepSeek V4 Pro, par exemple, est affiché à 0,435 dollar par million de tokens en entrée et 0,87 dollar en sortie, avec une remise promotionnelle permanente de 75 %.
En fixant Luna à 0,20 dollar en entrée, OpenAI sous-coupe DeepSeek sur les tokens d'entrée, bien qu'il reste plus cher en sortie. Les éditeurs chinois de modèles à poids ouverts avaient eux-mêmes relevé leurs tarifs après deux ans de sous-cotation. La convergence est en marche, et elle profite directement à quiconque paie des factures d'API.
Ce que ça change pour les apps web boostées à l'IA : un effet décisif sur la qualité
Chez RH Performances, où je pilote la stratégie marketing et les déploiements IA depuis 2021, j'ai construit et mis en production plusieurs applications web boostées à l'IA via l'API Claude. Je pilote la consommation token par token, entrée et sortie séparément, et j'optimise la facture en continu. La contrainte budgétaire m'a longtemps contraint à choisir des modèles peu coûteux : Claude Haiku 4.5 à 1 dollar en entrée et 5 dollars en sortie, ou Claude Sonnet 4.6 à 3 dollars en entrée et 15 dollars en sortie. Des modèles solides, mais clairement en dessous de la qualité d'Opus sur les tâches de raisonnement et de génération structurée.
La logique était simple et frustrante à la fois : Haiku pour les volumes, Sonnet pour les tâches intermédiaires, et Opus réservé aux workflows ponctuels où la qualité primait sur le coût. Le résultat : des outputs corrects, mais avec une marge de progression visible sur la richesse des analyses et la précision des données générées.
La baisse des prix de juillet 2026 change cette équation de façon décisive. Opus 5 à 5 dollars en entrée et 25 dollars en sortie est désormais le point d'équilibre idéal pour la plupart des workflows en production. Ses gains d'efficacité, moins de tentatives, moins de tokens, meilleure auto-vérification, font qu'il peut revenir moins cher en pratique qu'un modèle moins cher qui nécessite davantage d'itérations. Concrètement, sur mes apps web en production, je peux envisager de monter d'un cran dans la gamme sans revoir le budget : mêmes coûts, meilleure qualité de contenu et de données générées. C'est exactement l'arbitrage que la baisse des prix rend enfin accessible.
Et la tendance s'accélère : Claude Sonnet 5 est à 2 dollars en entrée et 10 dollars en sortie par million jusqu'au 31 août 2026, avant de passer à 3 dollars et 15 dollars. Pour les apps web qui tournent principalement sur Sonnet 4.6, c'est une fenêtre de migration à ne pas rater : un modèle de génération supérieure pour un coût identique, voire inférieur, pendant un mois.
Quelles tâches automatiser en priorité ? La grille de décision
La baisse des prix ne dit pas quoi automatiser. Elle dit juste que la liste des cas rentables s'allonge. Un bon candidat à l'automatisation coche trois cases : la tâche est répétitive, elle a un volume suffisant, et une erreur ponctuelle ne coûte pas cher à corriger. Dès qu'une décision engage vraiment, l'humain garde la main.
| Type de tâche | Exemples concrets | Bon candidat ? | Qui garde la main |
|---|---|---|---|
| Répétitive, fort volume, faible enjeu unitaire | Tri et catégorisation d'emails, support niveau 1, fiches produits, résumés de comptes rendus, extraction de données de factures | Oui, à traiter en priorité | Contrôle par échantillon |
| Répétitive mais à enjeu | Préparation de devis, brouillons de réponses RH ou juridiques, pré-qualification de leads | Assistance oui, décision non | Validation humaine systématique |
| Rare, fort enjeu, jugement requis | Recrutement, arbitrage budgétaire, gestion d'un litige client | Aide à la préparation seulement | L'humain décide, toujours |
| Créative de marque ou relation sensible | Ligne éditoriale, négociation, communication de crise | Non, l'IA produit un brouillon | L'humain, de bout en bout |
La logique tient en une phrase : commencez par les tâches ennuyeuses à fort volume, gardez l'humain sur les décisions qui engagent. GPT-5.6 Luna est d'ailleurs explicitement positionné par OpenAI pour les tâches à haut volume : classification de documents, tri de demandes clients, changements de code bien définis. Le modèle peut utiliser des outils et traiter des workflows multi-étapes, ce qui en fait un composant pratique pour les applications agentiques.
Pour aller plus loin sur la façon dont les agents IA peuvent prendre en charge ces workflows, l'article sur les agents IA pour l'automatisation et l'audit détaille des cas concrets et des garde-fous à exiger avant de déployer.
Le prix au token ne fait pas la facture réelle
C'est le point que les annonces tarifaires masquent systématiquement. Le coût par token est la partie visible et, franchement, la moins déterminante à l'échelle d'un projet en production. Ce qui pèse vraiment, c'est le reste.
- La longueur du contexte fourni au modèle : plus vous injectez de documents, de données CRM ou d'historique, plus la facture monte, indépendamment du tarif affiché.
- Le nombre d'allers-retours : un agent qui valide, corrige et reformule génère trois à cinq fois plus de tokens qu'un appel unique.
- La qualité de vos données : des données sales forcent le modèle à davantage d'inférences. Nettoyez vos sources avant d'automatiser.
- La couche d'intégration : le travail de branchement entre l'IA, votre CRM, vos formulaires et vos outils métier représente souvent 70 % du coût réel d'un projet.
Un fournisseur publie un tarif pour un million de tokens en entrée et en sortie, mais l'acheteur paie pour un workflow complet : contexte, raisonnement, appels d'outils, tentatives et révision humaine. Deux équipes utilisant exactement le même modèle au même tarif peuvent avoir des factures très différentes selon la façon dont c'est architécturé.
C'est précisément pour ça que, dans les workflows Make et n8n que je déploie, le choix du modèle reste une variable interchangeable. Quand Luna baisse de 80 % du jour au lendemain, on bascule sans tout réécrire. La valeur n'est pas dans le modèle, elle est dans la couche qui l'entoure. Pour comprendre comment formuler vos requêtes pour tirer le meilleur de ces modèles au meilleur coût, la page sur le prompt engineering donne des méthodes directement applicables.
Grok et les autres : le marché ne se résume pas à trois acteurs
Claude, Gemini et OpenAI concentrent l'attention, mais la pression tarifaire vient aussi de Grok (xAI) et des modèles open source chinois. Anthropic, Google, Mistral et OpenAI occupent les mêmes trois niveaux tarifaires depuis le début de juillet 2026, et la compétition s'est déplacée vers les deux paliers inférieurs, ceux qui absorbent les volumes.
La leçon stratégique est simple : ne vous liez pas contractuellement à un modèle unique. Architecturez vos automatisations pour que le modèle soit remplaçable à tout moment. Le marché bougera encore dans les prochains mois, et celui qui garde de la flexibilité capturera chaque vague de baisse sans frais de migration.
Ce que ça change pour votre stratégie d'automatisation en 2026
La chute des prix ne transforme pas l'IA en solution magique. Elle élargit la liste des tâches où elle devient rentable. Le bon réflexe n'est pas de courir après le dernier modèle, mais de repérer une ou deux tâches répétitives et chronophages chez vous, puis de les automatiser proprement avec un point de contrôle humain.
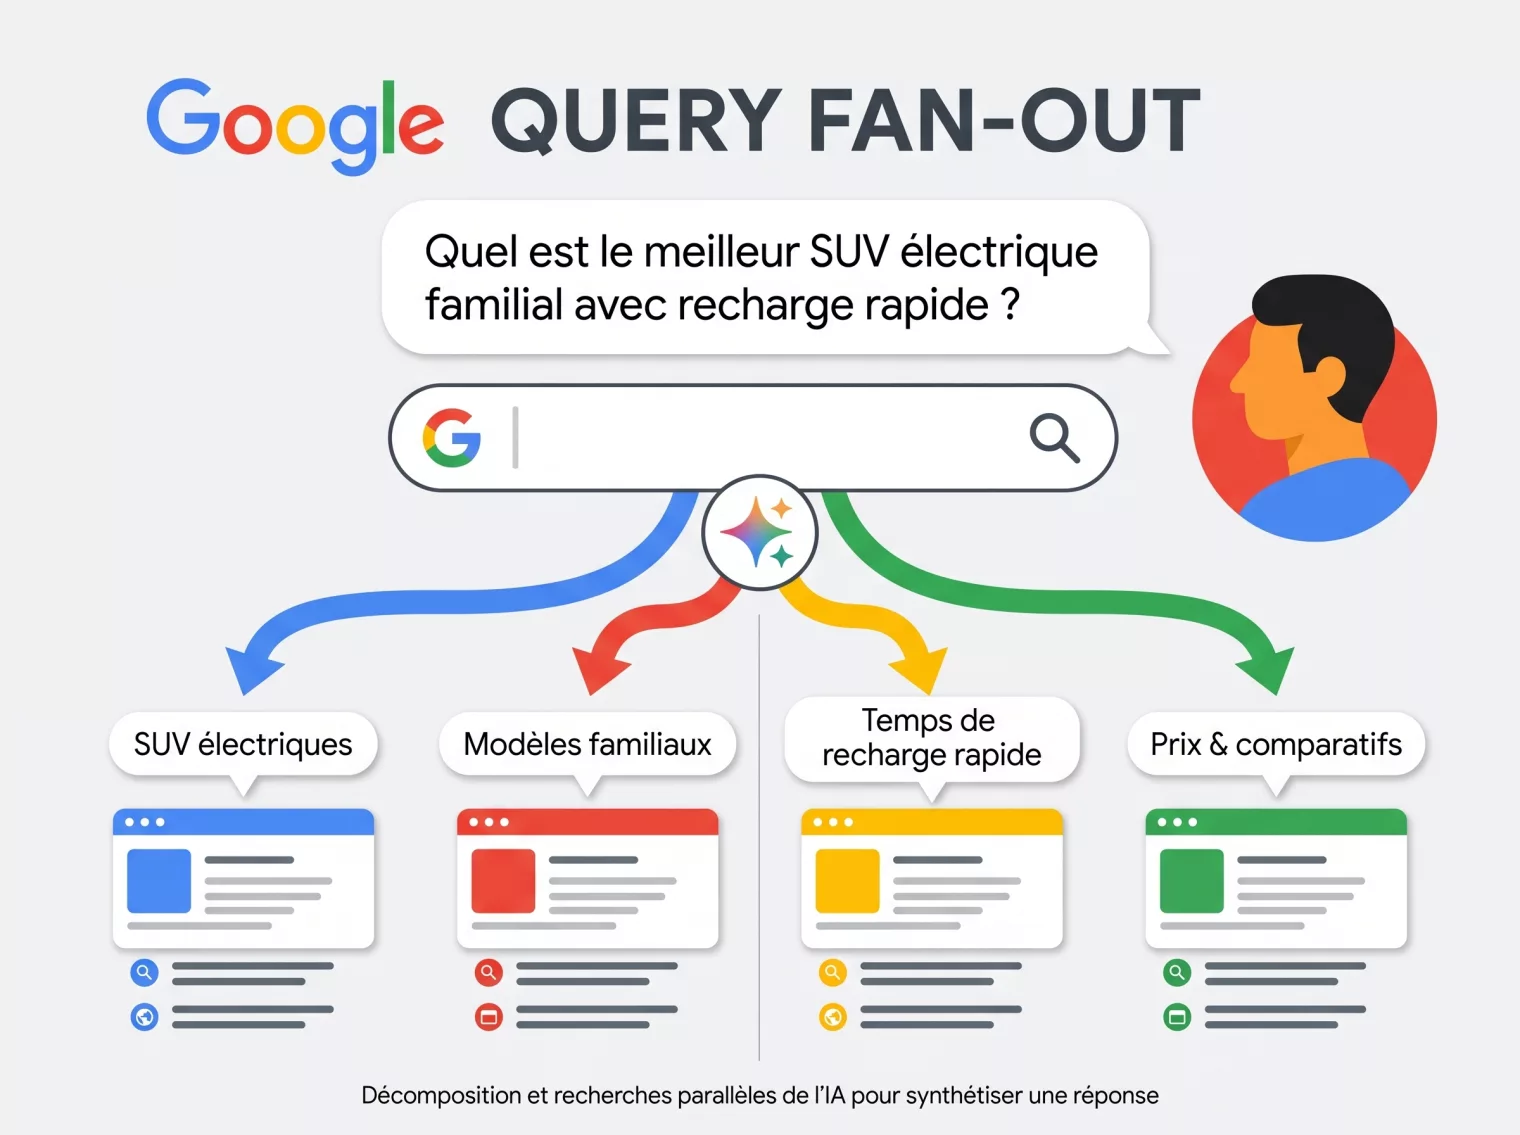
Sur la question du positionnement GEO et de la visibilité dans les moteurs génératifs, les prix qui baissent ont aussi un impact indirect : les équipes qui produisent plus de contenu utile et structuré grâce à l'IA vont creuser l'écart. Si ce sujet vous intéresse, l'article sur le query fan-out et la stratégie de contenu explique comment les moteurs génératifs décomposent vos requêtes et comment en tirer parti.
Les +634 % de trafic organique et +1 191 % de leads que nous avons générés en quatre ans chez RH Performances reposent sur une conviction simple : automatiser les tâches sans valeur ajoutée pour libérer du temps humain sur celles qui en ont. Les tarifs de juillet 2026 ne changent pas cette conviction, ils l'accélèrent.
FAQ
Quelle est la différence entre GPT-5.6 Luna, Terra et Sol ?
Sol est conçu pour les workloads de raisonnement complexe et les tâches agentiques avancées. Terra est pensé pour un usage de production généraliste où l'équilibre entre capacité et efficacité est requis. Luna est positionné pour les tâches à fort débit et faible latence : résumé, classification, routage, assistants temps réel où le coût par requête est la contrainte principale.
La baisse de prix de Claude Opus 5 est-elle réelle ?
Claude Opus 5 a été lancé le 24 juillet 2026 à 5 dollars en entrée et 25 dollars en sortie par million de tokens, un tarif identique à Opus 4.8, tout en délivrant des performances proches de Claude Fable 5 à la moitié de son prix. La baisse est donc relative : le tarif ne bouge pas, mais la capacité délivrée pour ce prix augmente significativement. À budget constant, vous obtenez davantage.
Les modèles chinois comme DeepSeek sont-ils vraiment moins chers ?
DeepSeek V4 Pro est affiché à 0,435 dollar par million de tokens en entrée et 0,87 dollar en sortie, bénéficiant d'une remise promotionnelle permanente de 75 %. Kimi K3, autre modèle chinois de référence, est à 3 dollars par million de tokens en entrée et 15 dollars en sortie. En fixant Luna à 0,20 dollar en entrée, OpenAI sous-coupe désormais DeepSeek sur les tokens d'entrée, mais reste plus cher en sortie.
Comment choisir entre Gemini 3.6 Flash, GPT-5.6 Luna et Claude Opus 5 pour une automatisation ?
La réponse dépend du type de tâche : pour le très haut volume à faible enjeu (classification, résumé, extraction), Gemini 3.6 Flash consomme 17 % de tokens de sortie en moins que son prédécesseur et Luna reste imbattable sur le coût brut. Pour les tâches de raisonnement ou d'analyse à enjeu modéré, Claude Opus 5 à 5 dollars en entrée et 25 dollars en sortie, ou Sonnet 5 à 2 dollars en entrée et 10 dollars en sortie jusqu'au 31 août 2026, offrent un excellent rapport qualité-prix. La clé : testez sur vos données réelles, mesurez le coût par tâche accomplie, pas le coût par token.
Écrit avec l'IA : le fond est de moi, la forme est d'elle.
Pour aller plus loin
Chouks - Article Visibility Optimizer
Le plugin WordPress SEO et GEO qui rend vos contenus citables par les moteurs IA.
Mes agents IA
Des agents IA gratuits du quotidien, à tester sans inscription.
Mon profil marketing et digital
Le CV interactif de Camille Dillies, côté marketing, growth et digital.